Vamos a montar un sistema donde vuelcas tus notas, PDFs y artículos, y luego le preguntas en lenguaje natural, bien desde una web, desde Claude, Codex o Cursor.
Pero nosotros vamos a ir un paso más allá y vamos a usar IA local, y no sólo la IA, sino que toda la info quede en nuestro equipo, sin enviar nada a la nube: los embeddings y la base de datos viven en tu propia máquina.
¿Qué es un «segundo cerebro» y por qué local?
Seguro que has escuchado eso del «segundo cerebro» y que la gente guarda ahí toda su vida, pero ¿qué es eso de un segundo cerebro o second brain?
Un segundo cerebro (o second brain) es una base de conocimiento personal: en vez de buscar por nombre de fichero o por carpetas, guardas todo y luego preguntas por significado. «¿Qué anoté sobre la fermentación de la masa madre?» y el sistema te devuelve el fragmento exacto, aunque tú hubieras escrito «levado» en lugar de «fermentación».
Eso se consigue con búsqueda semántica: cada texto se convierte en un vector (una lista de números que representa su significado) y se buscan los vectores más parecidos a tu pregunta.
En nuestro caso, la palabra clave del montaje es local: los modelos de IA corren en tu ordenador (con Ollama), tus notas nunca salen de tu disco (privacidad total, sin cuotas de API, sin depender de internet) y además no sólo vamos a montar una web desde el que poder usarlo, sino que le daremos superpoderes MCP para que puedas conectarlo con tu claude, codex o moelo de IA local que permita «tools» y así poder buscar, editar o subir a nuestro cerebro.
La arquitectura de un vistazo
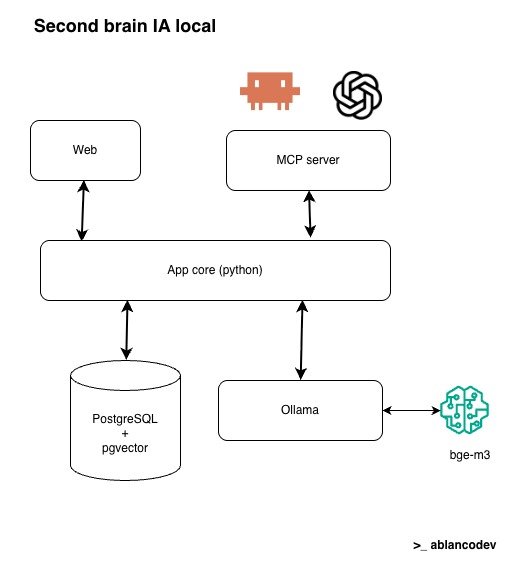
- Ollama + bge-m3 — convierte texto en vectores (embeddings). Corre nativo en tu Mac/PC (montarlo en Docker supone pérdida de rendimiento, así que los modelos de IA, siempre quedamos vamos a montarlos directamente en el equipo)
- PostgreSQL + pgvector — nuestra base de datos vectorial. Guarda notas, trozos y vectores; busca por similitud. Corre en Docker.
- Core (la app) (Python) – Orquesta toda la funcionalidad (
- Servidor MCP (Python) — conecta el asistente LLM/agente con el core (la app). Lo consumen LLMs / agentes.
- Interfaz web – Montada con FastAPI en Python (más que nada para que puedas ver algo chulo, porque te digo yo que el menda va a tirar de mcp en su día a día). Lo consumen humanos, como tú y yo.
El flujo, en dos direcciones
Cuando guardas algo (una nota, un PDF, una URL): el texto se trocea en fragmentos (chunks), cada fragmento se manda a Ollama que devuelve su vector de 1024 dimensiones, y fragmento + vector se guardan en PostgreSQL/pgvector.
Cuando preguntas: tu pregunta se convierte en un vector (mismo modelo bge-m3), pgvector busca los fragmentos más cercanos por similitud coseno (índice HNSW), y el asistente recibe esos fragmentos con su fuente original (título, ruta/URL, página) y te responde citándolos.
Por qué cada tecnología
- Ollama ejecuta modelos de IA en local, sin nube. Aquí lo usamos solo para embeddings, barato y rápido incluso sin GPU dedicada.
- bge-m3 es un modelo de embeddings multilingüe (va estupendo en español) que genera vectores de 1024 dimensiones y aguanta bien textos largos.
- PostgreSQL + pgvector añade el tipo
vectora Postgres y permite búsquedas por similitud coseno con índices HNSW. Bonus: es una base de datos «de verdad», con copias de seguridad y SQL de siempre. - MCP (Model Context Protocol) es el estándar que permite exponer herramientas a Claude, Codex o Cursor. Nuestro servidor publica tools como
search_notesoadd_note. - Web, por tener una interfaz chula con la que trabajar, montada con FastAPI en Python (cuando lo montemos, irá a http://127.0.0.1:8800)
Manual de montaje
Requisitos
- Docker Desktop (para Postgres).
- Ollama nativo + el modelo de embeddings:
ollama pull bge-m3. - uv (gestor de Python moderno) para lanzar el MCP.
1. La base de datos con pgvector (Docker)
services:
  db:
    image: pgvector/pgvector:pg16
    container_name: secondbrain-db
    environment:
      POSTGRES_USER: secondbrain
      POSTGRES_PASSWORD: secondbrain
      POSTGRES_DB: secondbrain
    ports:
      - "5433:5432"
    volumes:
      - ./storage/postgres:/var/lib/postgresql/data
      - ./init.sql:/docker-entrypoint-initdb.d/init.sql:ro
Mapeamos el puerto a 5433 para no chocar con un Postgres que ya tuvieras en el 5432. Los datos persisten en ./storage/postgres.
2. El esquema: cerebros, notas y chunks
CREATE EXTENSION IF NOT EXISTS vector;

CREATE TABLE chunks (
    id         BIGSERIAL PRIMARY KEY,
    note_id    BIGINT NOT NULL REFERENCES notes(id) ON DELETE CASCADE,
    chunk_idx  INT NOT NULL,
    content    TEXT NOT NULL,
    embedding  VECTOR(1024)   -- bge-m3 = 1024 dimensiones
);

CREATE INDEX chunks_embedding_hnsw
    ON chunks USING hnsw (embedding vector_cosine_ops);
Dos ideas importantes: la dimensión del VECTOR(1024) debe coincidir con el modelo (bge-m3 son 1024), y guardamos también un índice full-text en español para combinar búsqueda semántica con búsqueda por palabra exacta.
3. El servidor MCP en Python
El servidor MCP es una capa fina (FastMCP). Toda la lógica vive en un paquete core/ desacoplado, y las interfaces (MCP, API REST, web) solo la invocan. Así puedes extenderla mañana sin reescribir nada. Las tools que el asistente ve: search_notes, related_notes, add_note, add_file, add_url, get_note, list_notes, más las de gestión de cerebros (así podemos tener varios cerebros y que cada uno trabaje con el suyo, o poder tener varios, uno para el trabajo, otro para lo personal …).
4. Conectarlo con tu asistente
El servidor MCP lo lanza el cliente por stdio, así que solo necesitas registrarlo. En Claude Code:
claude mcp add secondbrain -- uv --directory "$(pwd)" run secondbrain-mcpEn Claude Desktop, Codex o Cursor, el mismo bloque JSON:
{
  "mcpServers": {
    "secondbrain": {
      "command": "uv",
      "args": ["--directory", "/ruta/a/secondbrain-local", "run", "secondbrain-mcp"]
    }
  }
}
Si un cliente muestra Failed to connect, casi siempre es que Postgres u Ollama están parados.
Second brain vs RAG
Un second brain es la idea (tu memoria externa personal). Un RAG es la maquinaria que la hace consultable por una IA. Este proyecto es un second brain implementado como RAG local: sin nube, sin coste de API y con tus datos sin salir de tu máquina.
En resumen:
Second Brain –> El producto
RAG –> La tecnología o arquitectura
Caso práctico: El cerebro «Antonio»
Para probar que la búsqueda semántica separa bien los temas, sembré un cerebro con notas de tres dominios muy distintos: IA/infra (Ollama, bge-m3, pgvector, MCP…), cocina (paella, masa madre, pan) y viajes (Japón, Kioto).
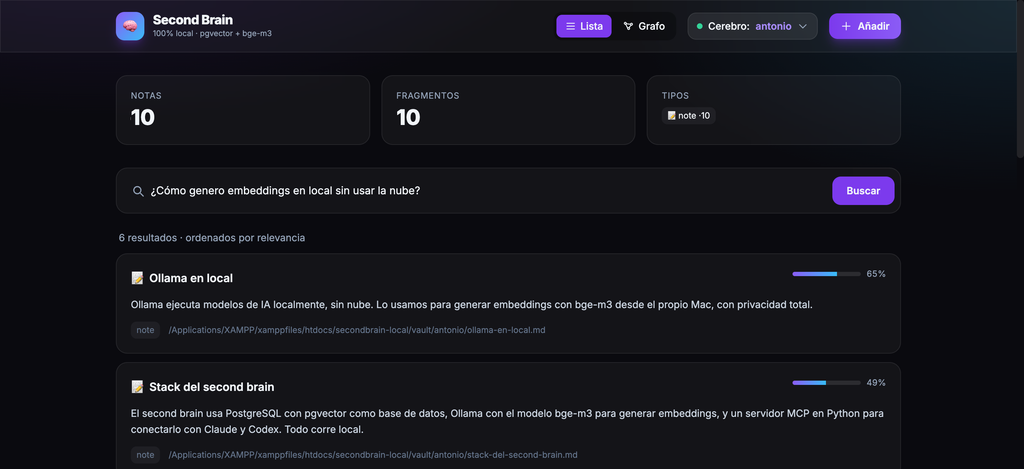
Además del chat del asistente, monté una interfaz web local (dark mode, como buen informático, con buscador semántico y vistas de lista y grafo (que esto de grafo vende mucho)) para ver el cerebro por dentro:
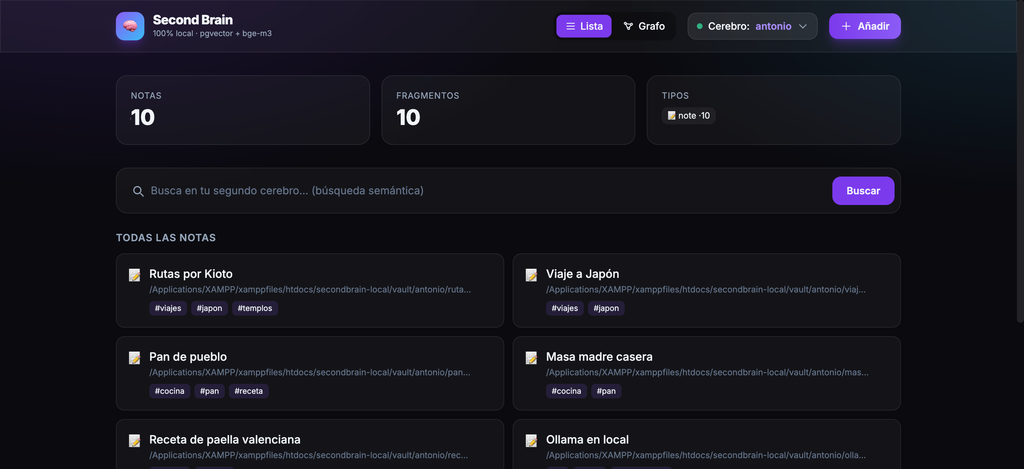
Ahora, desde el buscador, basta con pedirlo en lenguaje natural: «¿Cómo genero embeddings en local sin usar la nube?». El sistema devuelve primero «Ollama en local» (65%), seguido del stack (49%), embeddings (46%) y pgvector (43%); las notas de cocina quedan muy por debajo. Compara significado, no palabras.
Si nos vamos a la vista de grafo de conocimiento tipo Obsidian, pero sin enlaces manuales, los enlaces entre nodos no van metidos a mano en los propios documentos como hace Obsidian, las conexiones entre notas se calculan solas por similitud entre sus embeddings (y por etiquetas compartidas).
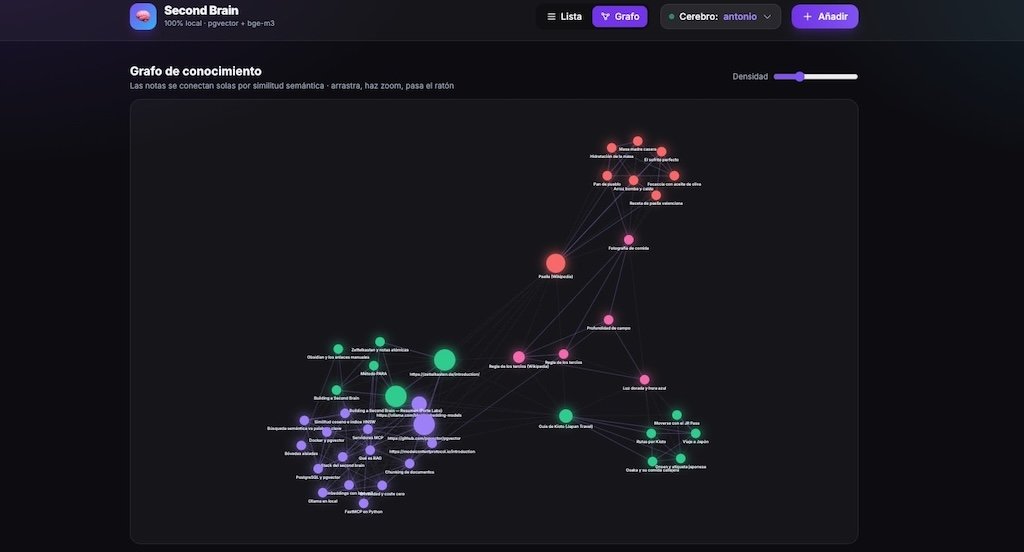
Se ve a simple vista cómo la IA agrupa las notas por tema sin que yo pusiera ni un solo enlace a mano: el clúster morado (IA/infra), el rojo (cocina) y el verde (viajes) aparecen separados porque sus embeddings así lo dicen.
Ventajas de hacerlo local
- Privacidad: tus notas y tus PDFs no salen del disco.
- Coste cero de API: los embeddings los calcula tu máquina.
- Sin internet: funciona en un avión.
- Portable: es Postgres estándar — copias de seguridad y consultas SQL de siempre.
- Multi-cliente: el mismo cerebro sirve a Claude, Codex y Cursor a la vez.
Montado con Ollama (bge-m3), PostgreSQL + pgvector y un servidor MCP en Python. IA 100% local: tus datos se quedan en casa, de donde nunca deberían salir 🙃
El repositorio
Seguro que quieres tener este sistema corriendo en tu máquina desde ya, así que te dejo el repositorio para que puedes descargarlo gratis y poder usarlo y evolucionarlo a tu antojo.